
はじめに
Webシステムの開発では、ReactやNext.js、Spring Bootなど、便利なフレームワークやライブラリを使う機会が増えました。
ルーティング、認証、データベース接続、画面の描画など、以前は自分たちで用意していた処理を、今では多くの道具が支えてくれます。
一方で、実際の開発現場には、古い実行環境や独自の制約によって、最新のフレームワークを導入できないシステムもあります。
そのような環境では、「フレームワークが使えないから、設計もできない」と考えてしまうかもしれません。
しかし、フレームワークが提供しているのは、特別な魔法だけではありません。
処理を役割ごとに分けること、依存する部品を外から渡すこと、すべてのリクエストに共通の処理を通すことなど、フレームワークの基礎になっている考え方があります。
これらの考え方は、フレームワークが使えない環境でも利用できます。
この記事では、レガシーなWebシステムを振り返りながら、現在の開発にもつながる基本的な設計を整理します。
flowchart LR
    A[レガシーな環境] --> B[フレームワークが使えない]
    B --> C[処理を自分で整理する]
    C --> D[階層モデル]
    C --> E[依存性注入]
    C --> F[共通のセキュリティ処理]
    D --> G[保守しやすい設計]
    E --> G
    F --> G
1. レガシーな技術を振り返る理由
ここでいうレガシーな技術とは、単に古い製品や古い言語だけを指しているわけではありません。
長く運用されているWebシステム、独自の実行環境、導入できるライブラリが限られた環境なども含めて考えます。
たとえば、次のような制約がある環境です。
| 制約 | 起こりやすいこと |
|---|---|
| 実行環境が古い | 新しいフレームワークを動かせない |
| 外部パッケージを追加できない | 便利な機能を自分で用意する必要がある |
| 既存コードを大きく変更できない | 小さな範囲から改善する必要がある |
| 長期間運用されている | 仕様と実装の両方が複雑になっている |
このような環境で大切なのは、最新の技術名を知っていることだけではありません。
どのように処理を分け、どのように依存関係を整理し、どこでアクセスを拒否するかを考える力が必要になります。
レガシーな技術を振り返ることは、古いものに戻ることではありません。
便利な道具の中に隠れていた、長く使える考え方を見つけ直すことです。
2. フレームワークは何をしてくれていたのか
フレームワークは、Webアプリケーションで何度も登場する処理を、あらかじめ整理してくれます。
| フレームワークの機能 | 開発者が得ていたもの |
|---|---|
| ルーティング | URLと実行する処理の対応付け |
| リクエスト処理 | 入力値の受け取りやレスポンスの返却 |
| テンプレート | HTMLとプログラムの分離 |
| データアクセス | データベース接続やSQL実行の共通化 |
| セッション管理 | ログイン状態の確認 |
| 認可処理 | 利用者ごとのアクセス権限の確認 |
| DIコンテナ | オブジェクトを組み立てて受け渡す処理 |
| 規約とディレクトリ構成 | チーム内で構造を揃える仕組み |
フレームワークは、Webシステムの「よくある構造」を先に用意してくれていると考えられます。
つまり、フレームワークを使うことと、設計をすることは別の話です。
フレームワークを使えば、設計上の判断を減らせる場合はあります。
それでも、処理の責務や依存関係を考える必要がなくなるわけではありません。
3. フレームワークがない環境で起きること
フレームワークを使わずに、1つのファイルへ処理を追加していくことを考えてみます。
最初は、次のような流れになるかもしれません。
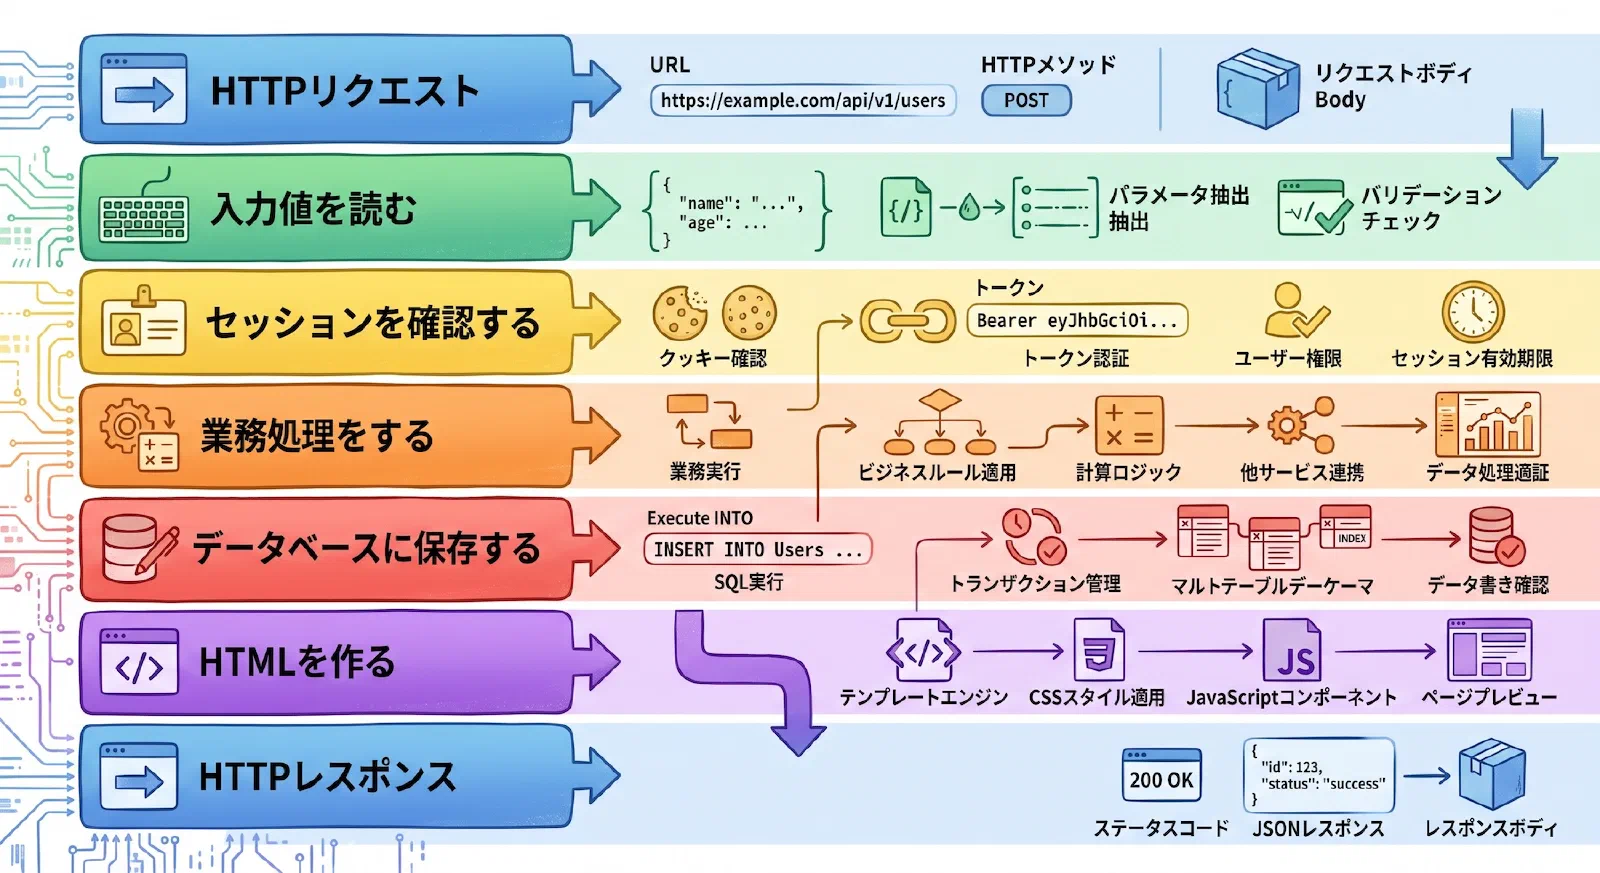
小さな画面であれば、この形でも動かすことはできます。
しかし、機能が増えると、次のような問題が起きやすくなります。
| 問題 | 困ること |
|---|---|
| 画面処理と業務処理が混ざる | どこを変更すればよいか分かりにくい |
| DB接続を直接呼び出す | テスト用のデータに差し替えにくい |
| セッション確認が画面ごとにある | 確認漏れや実装のばらつきが起きる |
| URLごとに権限処理を書く | 管理画面などの保護を忘れやすい |
| 同じ処理が複数箇所に現れる | 修正漏れが起きやすい |
問題の中心は、コードが古いことだけではありません。
処理の役割と、処理を通過する順番が整理されていないことが問題です。
4. リクエストの入口に共通処理を集約する
ここまで見てきたのは、1つのリクエストの中で、画面処理、業務処理、データベース処理が混ざってしまう問題でした。
しかし、整理したいのは処理の中身だけではありません。
リクエストがシステムのどこを通って処理されるのか、その通り道も整理する必要があります。
家にたとえるなら、部屋の役割を分けるだけでなく、玄関をどこに置き、誰を中へ通すのかも決めておく必要があります。
Webシステムでも、すべてのリクエストを共通の入口へ通すことで、複数の画面に共通する処理を一か所に集約できます。
フレームワークでは、この入口がミドルウェア、フィルター、インターセプターなどの仕組みとして提供されていることがあります。
名前は違っていても、役割は似ています。
リクエストを本来の処理へ渡す前に、共通の確認を行う仕組みです。
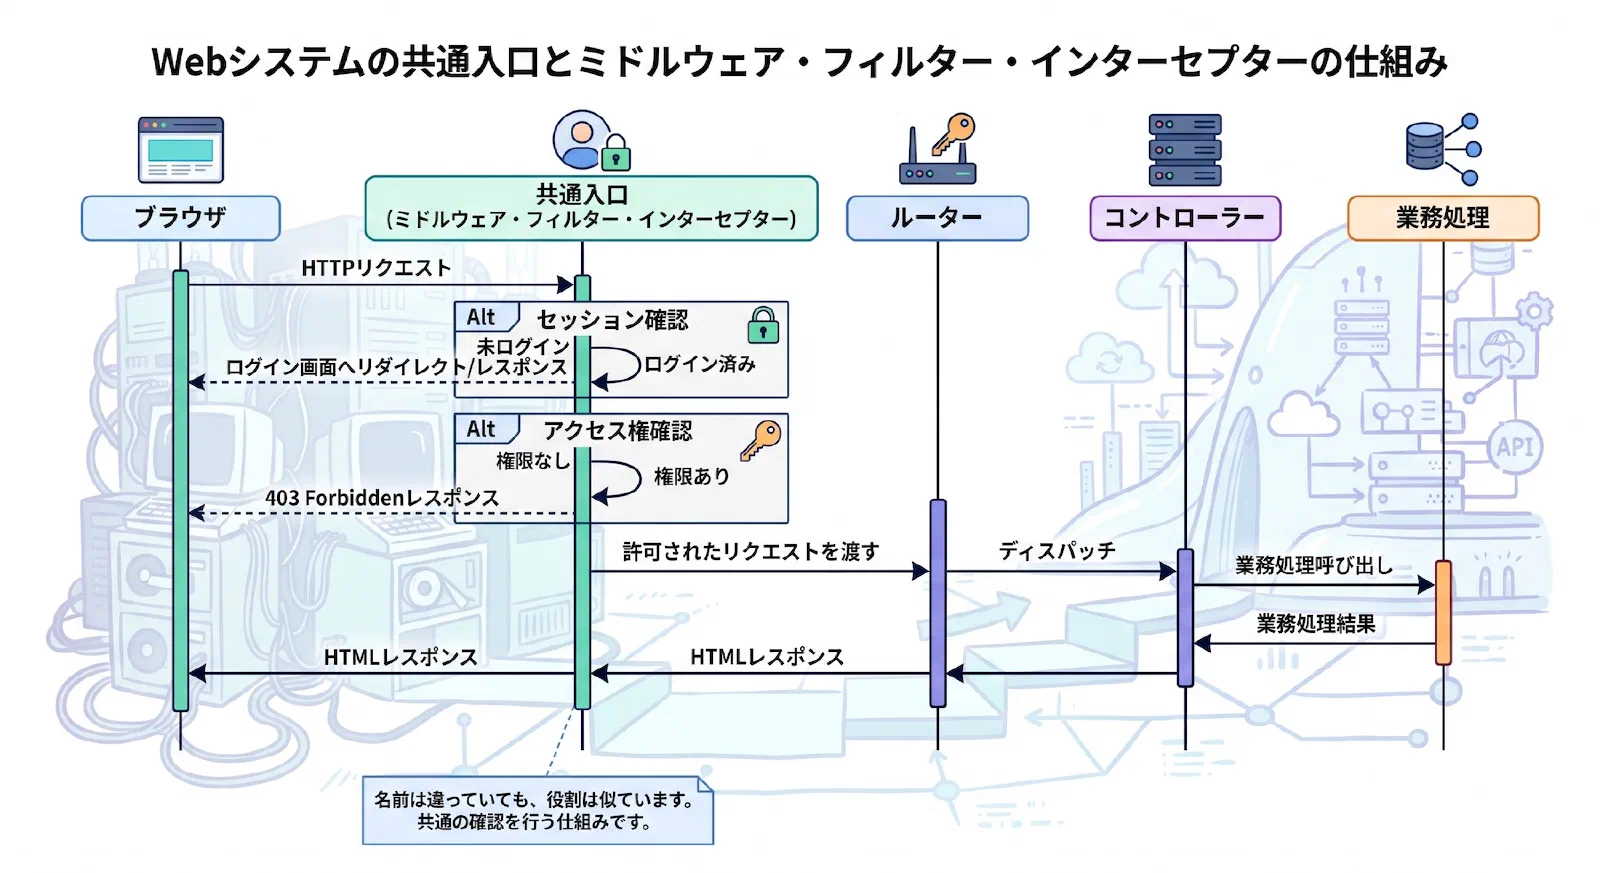
共通の入口という考え方
共通の入口に集約できる処理には、次のようなものがあります。
| 共通処理 | 役割 |
|---|---|
| セッション確認 | ログイン済みかを確認する |
| アクセス権確認 | 操作してよい利用者かを確認する |
| 入力値検証 | 不正な値を処理へ渡さない |
| ログ出力 | リクエストやエラーを記録する |
| エラー処理 | 内部の情報を不用意に表示しない |
この中でも、特に重要なのがセッション確認やアクセス権確認などのセキュリティ対策です。
これらを画面ごとに個別実装すると、確認漏れや実装のばらつきが起きやすくなります。
そこで、まずはセキュリティ処理を例に、共通の入口へ処理を集約する方法を見ていきます。
セッション確認とアクセス権確認
セッション確認は、利用者がログイン済みかどうかを確かめる処理です。
一方、アクセス権確認は、その利用者が目的の処理を実行してよいかを確かめる処理です。
この2つは似ていますが、同じではありません。
ログインしている利用者であっても、管理者向けの画面を操作できるとは限りません。
| 確認 | 問いかけていること | 失敗した場合の例 |
|---|---|---|
| 認証 | その利用者は誰か | ログイン画面へ移動する |
| 認可 | その利用者は操作してよいか | 403 Forbiddenを返す |
URLを直接指定された場合の防御
画面にリンクを表示していないことは、アクセス制御にはなりません。
URLを直接入力された場合や、APIを直接呼び出された場合にも、サーバー側で権限を確認する必要があります。
たとえば、管理画面へのリンクを隠すだけでは不十分です。
管理画面のURLへ直接アクセスされても、共通の入口で拒否できる構造にします。
| |
非公開情報をWeb公開領域に置かない
画像やファイルなどをURLで配信する場合は、ファイルの置き場所にも注意が必要です。
Webサーバーが直接配信するディレクトリに置かれたファイルは、アプリケーションのセッション確認を通らずに取得される可能性があります。
非公開のファイルは公開ディレクトリの外に置き、必要な場合だけ認証・認可を通した処理から返す方法が安全です。
共通処理に集約することは、セキュリティ対策の漏れを減らす助けになります。
ただし、共通処理を作っただけで安全になるわけではありません。
認証、認可、CSRF対策、入力値検証、エラー時の情報漏えい対策などを、それぞれ適切に確認する必要があります。
5. 階層モデルで処理を整理する
処理を役割ごとに分ける方法の1つが、階層モデルです。
Webシステムを、画面に近い処理からデータに近い処理まで分けて考えます。
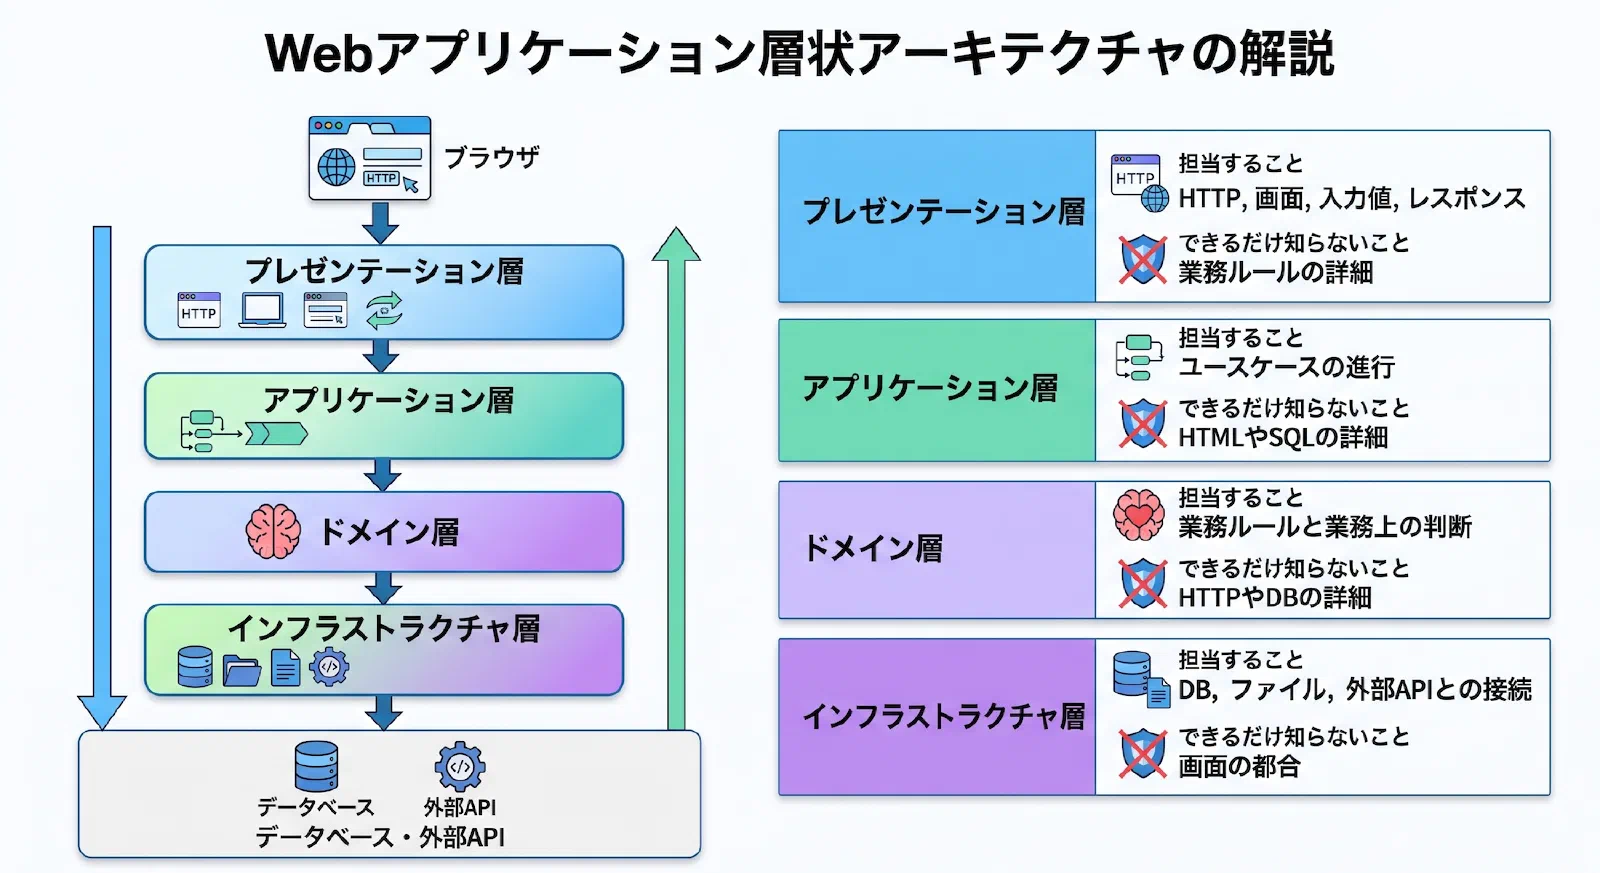
ここで大切なのは、フォルダを分けることだけではありません。
それぞれの層が「何を知ってよいか」を決めることが大切です。
たとえば、ドメイン層がHTTPのセッションやデータベースの接続方法を知っていると、業務ルールと技術的な詳細が強く結び付きます。
その状態では、DBを変更したり、Web画面以外から同じ業務処理を呼び出したりすることが難しくなります。
依存する方向をそろえる
基本的には、画面に近い層から業務処理を呼び出し、業務処理からデータアクセスの抽象的な窓口を呼び出します。
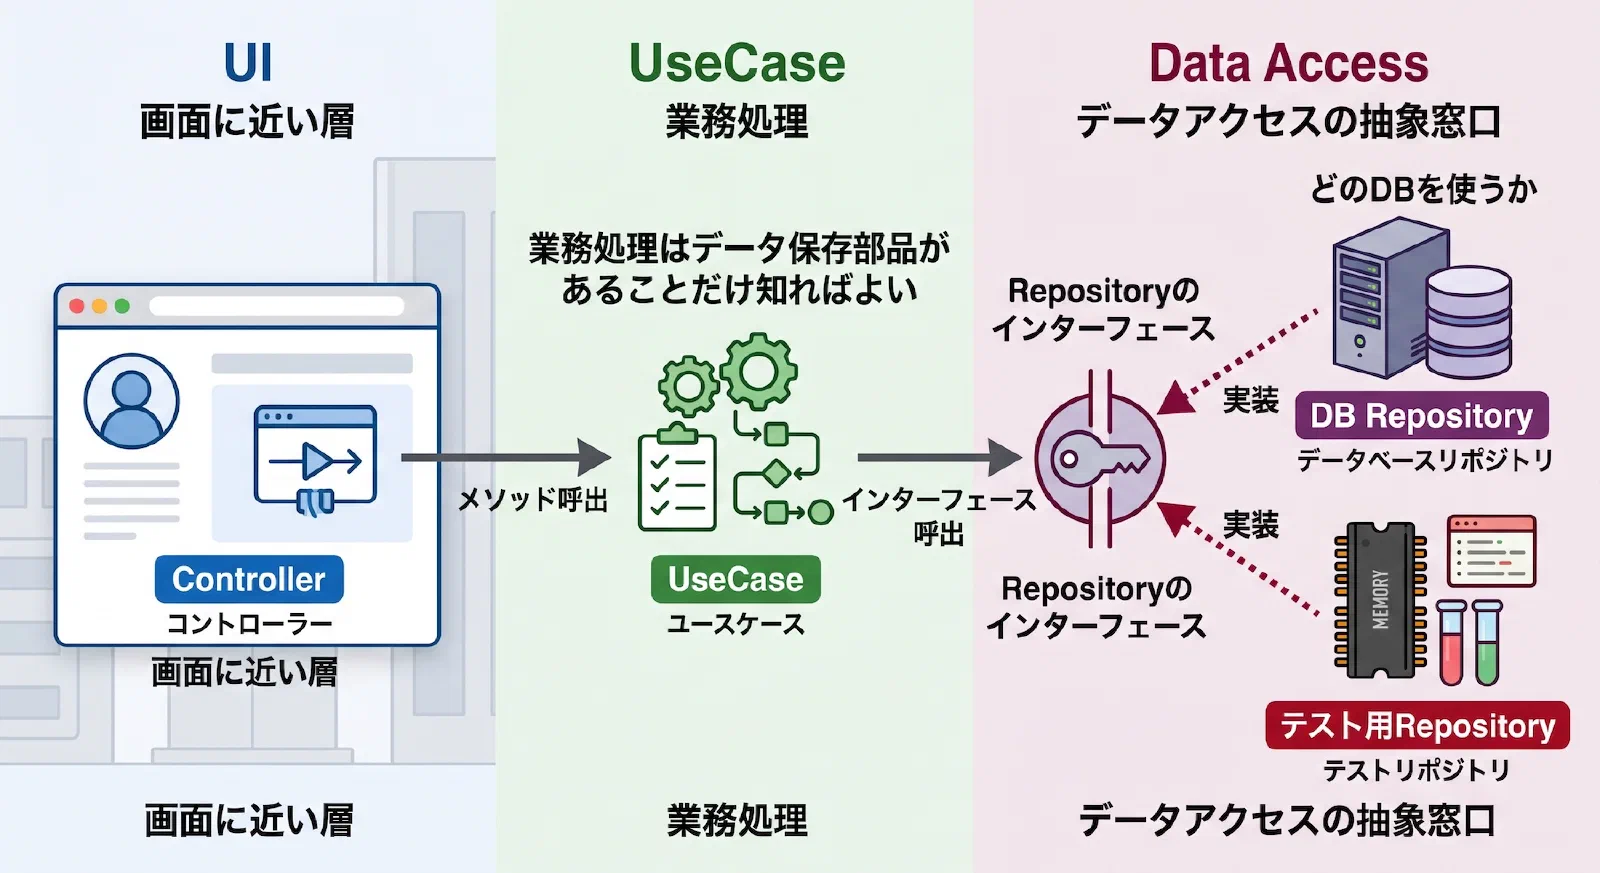
これにより、業務処理は「どのDBを使うか」ではなく、「データを保存できる部品がある」ことだけを知ればよくなります。
6. 依存性注入は「必要な部品を外から渡す」考え方
依存性注入という名前は少し難しく見えます。
考え方は、必要な部品を自分の中で作らず、外から受け取ることです。
料理にたとえるなら、料理人が畑まで行って野菜を育てるのではなく、必要な食材を外から受け取って料理するイメージです。
クラスの中で部品を作る場合
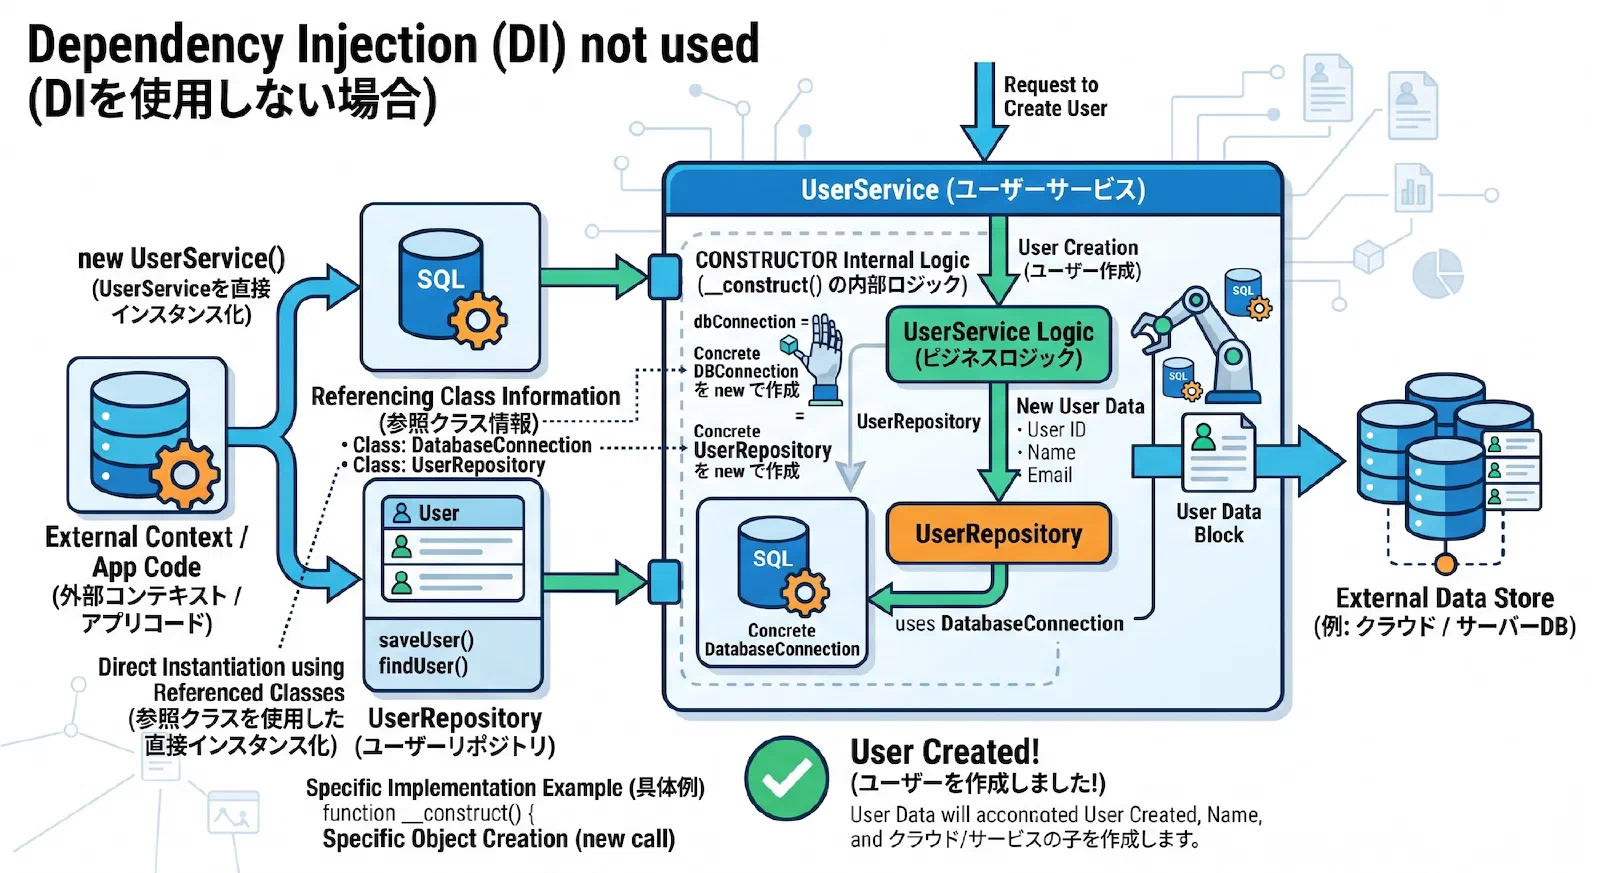
この場合、UserServiceはデータベースの種類や接続方法まで知ることになります。
部品を外から渡す場合
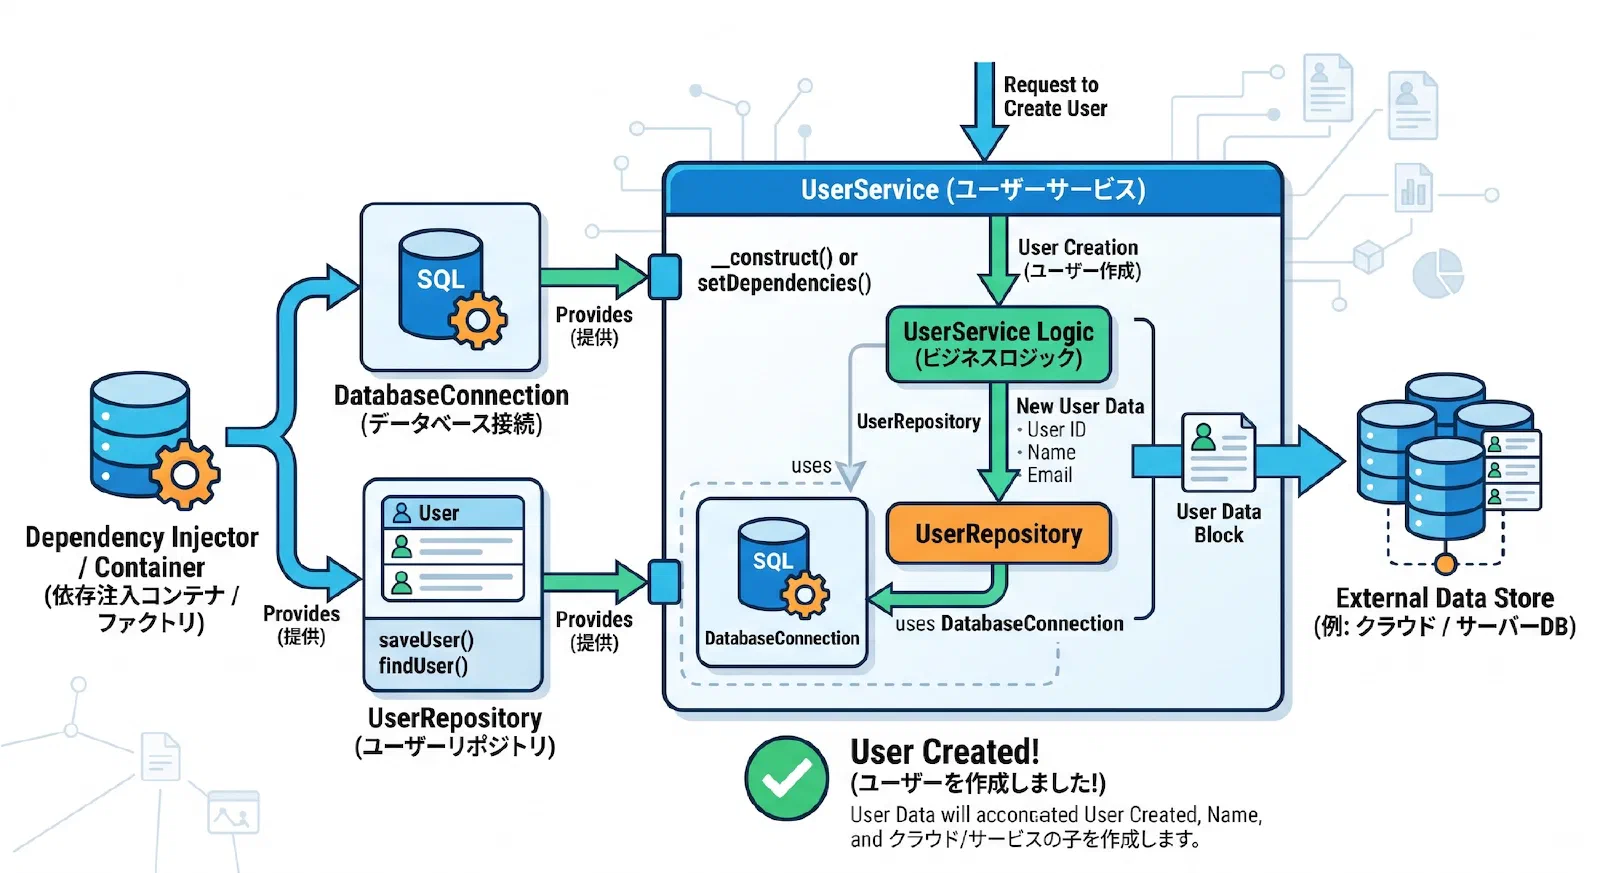
簡単な擬似コードで書くと、次のようになります。
| |
DIコンテナがなくても、依存性注入は手作業で実現できます。
DIコンテナは依存性注入そのものではなく、部品の組み立てを自動化する道具です。
小さなシステムでは、起動処理に部品の組み立てを明示的に書く方が、動きを理解しやすい場合もあります。
依存性注入で何が変わるのか
| 変更前 | 変更後 |
|---|---|
| ServiceがDBを直接作る | 起動処理がDBを作る |
| Serviceが具体的な実装を知る | Serviceが抽象的な窓口を使う |
| テスト時も本物のDBが必要 | テスト用の部品に差し替えられる |
| 変更の影響が広がりやすい | 部品ごとに変更しやすい |
依存性注入の目的は、難しい仕組みを導入することではありません。
部品同士の結び付きを弱くし、変更やテストをしやすくすることです。
7. フレームワークなしで小さなWebシステムを組み立てる
ここまでの考え方を、ユーザー登録のような小さな機能に当てはめます。
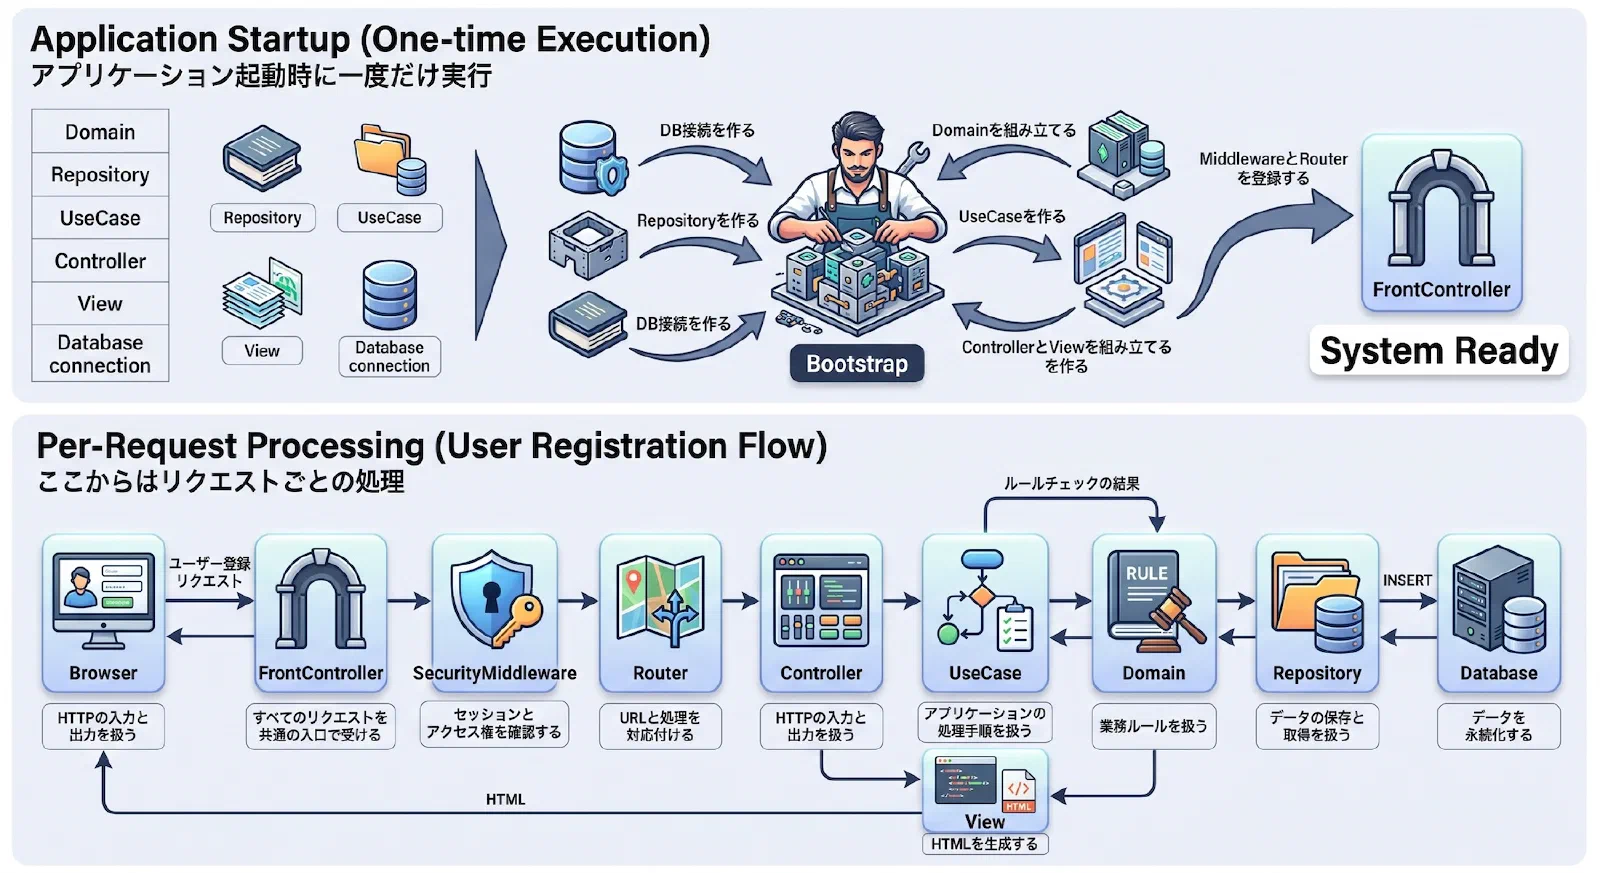
この図では、Bootstrap と通常のリクエスト処理を分けて表現しています。Bootstrap はアプリケーションの起動時に、データベース接続やRepository、UseCase、Controller、Viewを組み立てます。
一度組み立てた部品をFrontControllerへ登録したあとは、リクエストごとにBootstrapが呼ばれるわけではありません。
リクエストはまずFrontControllerを通り、SecurityMiddlewareでセッションと権限を確認します。
その後、RouterがURLに対応するControllerを呼び出します。
ControllerはUseCaseを呼び出し、UseCaseはDomainの業務ルールとRepositoryのデータ操作を組み合わせます。
処理結果を受け取ったControllerは、その結果をViewへ渡します。
Viewは、その結果をHTMLへ変換してControllerへ返します。
このように、Controllerは処理の順番を調整し、Viewは表示形式を担当します。
重要なのは、これらを大規模な仕組みとして作ることではありません。
小さくても、処理の順番と責任の範囲を決めることです。
8. どこまで自作し、どこから道具を使うか
フレームワークが使えない環境で考え方を実践できるからといって、すべてを自作する必要はありません。
| 状況 | 方針 |
|---|---|
| 小規模で変更も少ない | 手動DIと単純な階層で十分 |
| チーム開発で処理が増える | 共通ルールやルーティングを整える |
| テスト対象が増える | インターフェースとDIを活用する |
| 認証・CSRF・入力検証が必要 | 実績のあるライブラリを使う |
| 長期運用する | フレームワーク導入も選択肢にする |
特にセキュリティに関わる処理は、安易に自作しない方がよい領域です。
パスワードのハッシュ化、暗号処理、セッション管理、CSRF対策などは、実績のある仕組みを優先します。
自分たちで設計するのは、主に処理の構造と依存関係です。
共通化しても安心しすぎない
セキュリティ処理を共通の入口に集約すると、確認漏れを減らしやすくなります。
しかし、次のような経路が残っていると、対策を回避される可能性があります。
- 共通の入口を通らずに実行できるファイルがある
- APIだけセッション確認をしていない
- 画面では権限を隠しているが、サーバー側で確認していない
- 非公開ファイルを公開ディレクトリに置いている
- 管理者用の処理と一般利用者用の処理で判定方法が違う
「すべての入口を一つにすること」と「サーバー側で必ず判定すること」が基本になります。
9. レガシーな技術から学べること
レガシーなWebシステムを振り返ると、現在のフレームワークにも通じる考え方が見えてきます。
| 振り返って分かること | 現在にもつながる考え方 |
|---|---|
| 処理を役割ごとに分ける | 階層モデルと責務分離 |
| 部品を外から渡す | 依存性注入 |
| 入口で共通処理を行う | ミドルウェアとセキュリティ集約 |
| URLと処理を分ける | ルーティング |
| 非公開情報を直接公開しない | サーバー側のアクセス制御 |
フレームワークは、これらの考え方を使いやすい形にまとめた道具です。
フレームワークを使わない場合でも、考え方まで失われるわけではありません。
むしろ、仕組みを自分で組み立てる必要があるからこそ、普段は意識していない設計の意味を理解しやすくなります。
おわりに
レガシーな技術を振り返ることは、古い技術をそのまま使い続けようという話ではありません。
レガシーなシステムには、当時の技術者が限られた環境や要件の中で積み重ねた知識、判断、工夫が残されています。
そこには、現在の私たちから見ると分かりにくい設計や、避けたい実装もあります。
しかし、それらのすべてが無意味だったわけではありません。
当時の制約の中で問題を解決するために選ばれた方法であり、長い運用の中で積み重ねられた知恵でもあります。
フレームワーク自体も、過去の技術者たちが繰り返し経験した問題への解決策を、使いやすい形にまとめたものだと考えられます。
フレームワークが提供していた機能を分解すると、階層化、依存性注入、ルーティング、共通のセキュリティ処理など、現在でも使える考え方が見えてきます。
フレームワークが使えない環境でも、これらを小さく手作業で取り入れることはできます。
大切なのは、レガシーな実装をそのまま受け入れることでも、最新技術へ無条件に置き換えることでもありません。
なぜその形になったのかを読み解き、今も使える考え方を次の設計へ持ち帰ることです。
レガシーな技術は、過去の技術者たちの知識・判断・工夫、そして現場での試行錯誤が積み重なったものです。
そこから学び直すことで、フレームワークの名前が変わっても通用する設計の基礎を見つけられるのではないでしょうか。
flowchart LR
    A[過去の技術者の知識・判断] --> D[レガシーなシステム]
    B[当時の制約] --> D
    C[現場での工夫・試行錯誤] --> D
    D --> E[現在の技術者が読み解く]
    D -.-> F[分かりにくい設計や妥協]
    F -.-> E
    E --> G[今も使える考え方]
    G --> H[次の設計へ持ち帰る]